配置要求
目标是配置一个基本的 Hadoop 分布式集群:
一台主节点:
master一台从节点:
slave1支持:HDFS + YARN
Java 已配置
Hadoop 已安装成功,路径在
/opt/hadoop(你可替换为实际路径)
使用 hadoop version 命令测试
注:前置参考资料在文末,建议先按照前置参考资料进行安装配置到 hadoop version 命令成功执行步骤,再继续参照本文章。
修改hosts、hostname
hosts: /etc/hosts 集群所有主机IP地址与对应主机名 格式:IP(空)主机名
hostname: /etc/hostname
主节点命名为master,子节点命名为slave1
把主机名直接写入此文件(只能保留一个名字),定义本机的主机名(可能需要重启生效)
使用 sudo hostnamectl set-hostname 新主机名 设置(即时生效)
使用 hostname 命令查看当前主机名
SSH 配置免密
1. 生成 SSH 密钥对(如果尚未生成)
在每台机器上执行:ssh-keygen -t rsa
一路回车即可(不要设置密码短语)。
2. 将自己的公钥添加到目标机器的 authorized_keys 中
在 master 上执行以下命令,把自己的公钥发给 slave1 :
ssh-copy-id root@localhost
ssh-copy-id root@slave1
同理,在 slave1 上执行:
ssh-copy-id root@localhost
ssh-copy-id root@master
从每台机器尝试 ssh 到其他机器(包括自己)进行验证:
ssh root@localhost
ssh root@master
ssh root@slave1
配置Hadoop的配置文件
1. core-site.xml
    hadoop.tmp.dir
    file:/opt/hadoop/tmp
    location to store temporary files

    fs.defaultFS
    hdfs://master:9000
2. hdfs-site.xml
    dfs.replication
    1

    dfs.namenode.name.dir
    file:/opt/hadoop/tmp/dfs/name

    dfs.datanode.data.dir
    file:/opt/hadoop/tmp/dfs/data
3. mapred-site.xml
    mapreduce.framework.name
    yarn


    yarn.app.mapreduce.am.env
    HADOOP_MAPRED_HOME=/opt/hadoop


    mapreduce.map.env
    HADOOP_MAPRED_HOME=/opt/hadoop


    mapreduce.reduce.env
    HADOOP_MAPRED_HOME=/opt/hadoop
4. yarn-site.xml
    yarn.resourcemanager.hostname
    master

    yarn.nodemanager.aux-services
    mapreduce_shuffle
5. workers(以前叫 slaves)
列出所有的从节点(一个 hostname 一行)。
slave1
复制配置文件
scp -r /opt/hadoop/etc/hadoop/ root@slave1:/opt/hadoop/etc/
启动 Hadoop
hdfs namenode -format
start-dfs.sh
start-yarn.sh
验证是否成功
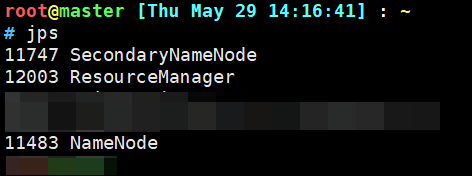
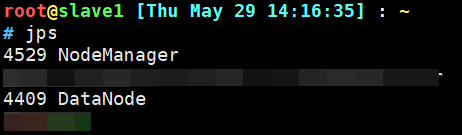
在 master 和 slave1 分别运行:jps
你应该看到:
- master 节点有:
NameNode
SecondaryNameNodeResourceManagerslave1 节点有:
DataNode
NodeManager
然后运行以下命令进行测试,检查是否有问题:
hdfs dfs -ls /
hdfs dfs -mkdir /testdir
hdfs dfs -ls /
echo "Hello Hadoop" > hello.txt
hdfs dfs -put hello.txt /testdir/
hdfs dfs -ls /testdir/
hdfs dfs -cat /testdir/hello.txt
hdfs dfs -get /testdir/hello.txt ./hello_from_hdfs.txt
hdfs dfs -rm /testdir/hello.txt
hdfs dfs -rmdir /testdir
hdfs dfsadmin -report
如果出现问题请先检查防火墙是否开放相应端口。
# 开放端口
for p in 9000 9870 {50010..50020} 50075 8088 8042 9864 9866 9867; do firewall-cmd --permanent --add-port=${p}/tcp; done && firewall-cmd --reload

# 关闭端口
for p in 9000 9870 {50010..50020} 50075 8088 8042 9864 9866 9867; do firewall-cmd --permanent --remove-port=${p}/tcp; done && firewall-cmd --reload
注意:经过后期实践,发现以上端口没有涵盖Hadoop的所有所需开放端口,最方便的解决方法是暂时关闭防火墙。